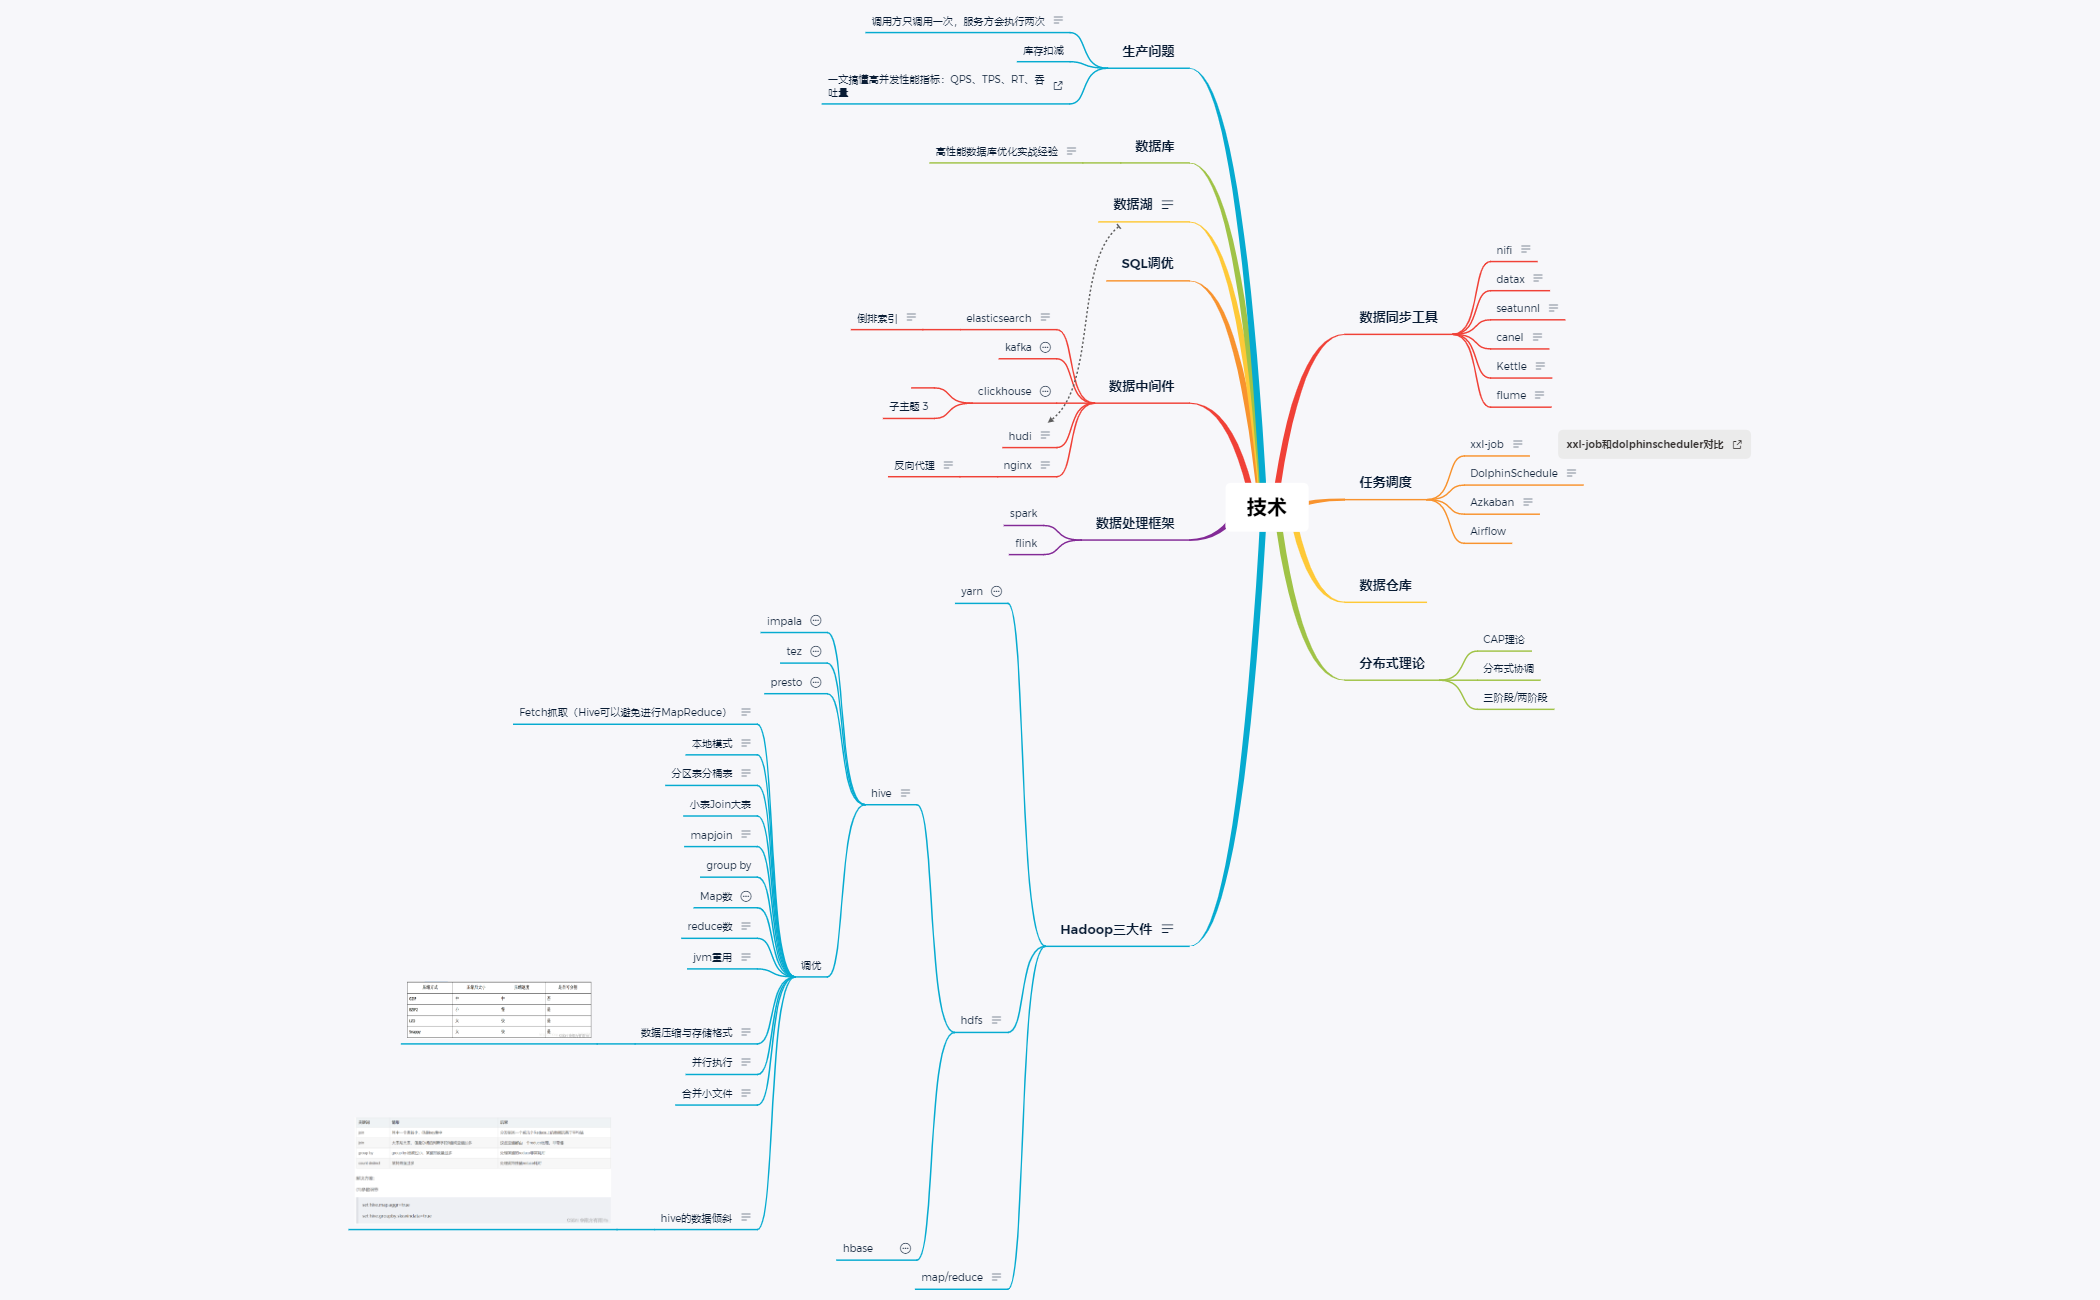
数据同步工具
nifi
NSA(National Security Agency [美国国家安全局])的一个项目,目前已经代码开源,是Apache基金会的顶级项目之一 可靠的数据拉取、数据处理和分发系统 高度可配置的指示图的数据路由、转换和系统中介逻辑,支持从多种数据源动态拉取数据。 NiFi基于Web方式工作,后台在服务器上进行调度。 用户可以为数据处理定义为一个流程,然后进行处理,后台具有数据处理引擎、任务调度等组件。
datax
DataX 单进程多线程 有流控功能 转换插件 容错 脏数据处理 本身作为数据同步框架,将不同数据源的同步抽象为从源头数据源读取数据的Reader插件,以及向目标端写入数据的Writer插件,理论上DataX框架可以支持任意数据源类型的数据同步工作。同时DataX插件体系作为一套生态系统, 每接入一套新数据源该新加入的数据源即可实现和现有的数据源互通。
Data-Web datax可视化
seatunnl
基于配置的低代码开发,易用性高,方便维护。 支持实时流式传输 离线多源数据分析 高性能、海量数据处理能力 模块化的插件架构,易于扩展 支持用SQL进行数据操作和数据聚合 它以Spark和Flink为引擎。所以可以很好地进行分布式的海量数据同步
canel
MySQL 主从复制过程 ➢ Master 主库将改变记录,写到二进制日志(binary log)中 ➢ Slave 从库向 mysql master 发送 dump 协议,将 master 主库的 binary log events 拷贝到它的中继日志(relay log); ➢ Slave 从库读取并重做中继日志中的事件,将改变的数据同步到自己的数据库。 canal 的工作原理 很简单,就是把自己伪装成 slave,假装从 master 复制数据
Kettle
有可视化界面 性能差 常被用于关系型数据库
flume
flume 是一个cloudera提供的 高可用高可靠,分布式的海量日志收集聚合传输系统。
任务调度
xxl-job
(1)支持通过Web页面对任务进行CRUD操作,可动态启动/停止任务,操作非常简单 (2)任务分布式执行,任务”执行器”支持集群部署,支持弹性扩容缩容; (3)丰富的路由策略,包括:第一个、最后一个、轮询、随机、故障转移、忙碌转移等; (4)完善的调度过期策略、任务超时控制、任务失败重试、任务失败告警等 (5)支持动态分配,分片广播(不同执行器可以同时执行不同的任务)任务以执行器为维度进行分片;并且分片广播任务:执行器集群部署时,任务路由策略选择”分片广播”情况下,一次任务调度将会广播触发集群中所有执行器执行一次任务 (6)有着完善的故障转移、任务进度监控、邮件报警等保护机制, (7)有着运行报表,和Rolling实时日志方便对正规任务进行实时的数据监控
DolphinSchedule
MasterServer 采用分布式无中心设计理念, MasterServer 主要负责 DAG 任务切分、任务提交、任务监控,并同时监听其它 MasterServer 和 WorkerServer 的健康状态。 WorkerServer 也采用分布式无中心设计理念, WorkerServer 主要负责任务的执行和提供日志服务。 ZooKeeper 服务,系统中的 MasterServer 和 WorkerServer 节点都通过 ZooKeeper 来进行集群管理和容错。 Alert 服务, 提供告警相关服务。 API 接口层,主要负责处理前端 UI 层的请求。 UI, 系统的前端页面,提供系统的各种可视化操作界面。
Azkaban
1、 Web用户界面 2、 方便上传工作流 3、 方便设置任务之间的关系 4、 工作流调度 5、 认证/授权 6、 能够杀死并重启工作流 7、 模块化和可插拔的插件机制 8、 项目工作区 9、 工作流和任务的日志记录和审计
Airflow
数据仓库
分布式理论
CAP理论
分布式协调
三阶段/两阶段
Hadoop三大件
hadoop 3.0 基于jdk1.8(最低版本要求) Hadoop 2.x - java的最低支持版本是java 7 1.纠删码将数据存储空间节省50% hadoop-3.0之前,HDFS存储方式为每一份数据存储3份,这也使得存储利用率仅为1/3, hadoop-3.0引入纠删码技术(EC技术),实现1份数据+0.5份冗余校验数据存储方式 2。Shell脚本重写 增加了参数冲突检测,避免重复定义和冗余参数 3.支持多个NameNode 但是Active的NameNode始终只有1个,余下的都是Standby。 Standby NN会不断与JN同步,保证自己获取最新的editlog,并将edits同步到自己维护的image中去,这样便可以实现热备,在发生failover的时候,立马切换成active状态,对外提供服务。同时,JN只允许一个active状态的NN写入 4.Disk Balance 支持单个Datanode上,不同硬盘间的数据balancer。老版本的hadoop只支持在Datanode之间进行balancer,每个节点内部不同硬盘之间若发生了数据不平衡,则没有一个好的办法进行处理。现在可以通过hdfs diskbalancer命令,进行节点内部硬盘间的数据平衡。该功能默认是关闭的,需要手动设置参数dfs.disk.balancer.enabled为true来开启 yarn
分布式调度已经引入了ExecutionType的概念,从而应用程序现在可以请求执行类型为Opportunistic的容器。即使在调度时没有可用的资源,也可以调度此类型的容器在NM处执行。在这种情况下,这些容器将在NM处排队,等待资源启动。机会容器的优先级低于默认的保证容器,因此如果需要的话,为抢占保证容器而腾出空间。这应该会提高群集利用率。
Capacity Scheduler队列配置的基于API的配置
MapReduce
MapReduce任务级本地优化(引入Native Task加速计算)
MapReduce内存参数自动推断
yarn
Yarn是Hadoop的一个资源管理器,是一个资源协调者角色。 ResourceManager(RM):RM是一个全局的资源管理器,负责整个系统的资源管理和分配。它主要由两个组件构成:调度器(Scheduler)和应用程序管理器(Applications Manager,ASM)。 处理客户端请求。 监控NodeManager。 启动或者监控ApplicationMaster。 资源的分配与调度。 NodeManager(NM):NM是每个节点上的资源和任务管理器,它需要不断的是将自己所在节点上的资源情况和Container运行状态汇报到RM上,同时还需要处理来自AM的命令。
管理单个节点上的资源。 处理来自ResourceManager的命令。 处理来自ApplicationMaster的命令。 ApplicationMaster:用户提交的每个应用程序均包含一个AM。
为应运程序申请资源并分配给内部的任务。 任务的监控与容错。 Contaioner:Container是一个动态资源分配单位,它将内存、CPU、磁盘、网络等资源封装在一起,从而限定每个任务使用的资源量。
Container是Yarn中的资源的抽象,它相当于是一台小型的机器,真正的运行任务的地方。
hdfs
HDFS集群分为两大角色:NameNode、DataNode NameNode负责管理整个文件系统的元数据 DataNode 负责管理用户的文件数据块 文件会按照固定的大小(blocksize)切成若干块后分布式存储在若干台datanode上 每一个文件块可以有多个副本,并存放在不同的datanode上 Datanode会定期向Namenode汇报自身所保存的文件block信息,而namenode则会负责保持文件的副本数量 HDFS的内部工作机制对客户端保持透明,客户端请求访问HDFS都是通过向namenode申请来进行
JournalNodes 两个NameNode为了数据同步,会通过一组称作JournalNodes的独立进程进行相互通信。当active状态的NameNode的命名空间有任何修改时,会告知大部分的JournalNodes进程。standby状态的NameNode有能力读取JNs中的变更信息,并且一直监控edit log的变化,把变化应用于自己的命名空间。standby可以确保在集群出错时,命名空间状态已经完全同步了。
-
hive
由 Facebook 开源用于解决海量结构化日志的数据统计工具
Hive就是一个查询引擎。当Hive接受到一条SQL语句会执行如下操作: 词法分析和语法分析。使用antlr将SQL语句解析成抽象语法树 语义分析。从MetaStore中获取元数据信息,解释SQL语句中的表名、列名、数据类型 逻辑计划生成。生成逻辑计划得到算子树 逻辑计划优化。对算子树进行优化 物理计划生成。将逻辑计划生成出的MapReduce任务组成的DAG的物理计划 物理计划执行。将DAG发送到Hadoop集群进行执行 将查询结果返回。
-
impala
Cloudera公司推出,提供对HDFS、Hbase数据的高性能、低延迟的交互式SQL查询功能。基于Hive,使用内存计算,兼顾数据仓库、具有实时、批处理、多并发 基于内存 中间结果写入磁盘 省去了大量io 数据和计算放在一个机器上
-
tez
Tez可以将多个有依赖的作业转换为一个作业(这样只需写一次HDFS,且中间节点较少),从而大大提升DAG作业的性能。
Tez+Hive与Impala均可用于解决Hive/Pig延迟大、性能低效的问题,Impala的出发点是抛弃MapReduce计算框架,不再将SQL或者PIG语句翻译成MR程序,而是采用传统数据数据库的方式,直接从DataNode上存取数据,而Tez+Hive则不同,Tez+Hive仍采用MapReduce计算框架,但对DAG的作业依赖关系进行了裁剪,并将多个小作业合并成一个大作业,这样,不仅计算量减少,而且写HDFS次数也会大大减少。
-
presto
是Facebook开源的,完全基于内存的并⾏计算,分布式SQL交互式查询引擎 是一种Massively parallel processing (MPP)架构,多个节点管道式执⾏ ⽀持任意数据源(通过扩展式Connector组件),数据规GB~PB级 使用的技术,如向量计算,动态编译执⾏计划,优化的ORC和Parquet Reader等 presto是通过connector plugin获取数据和元信息的,它不是⼀个数据存储引擎,不需要有数据,presto为其他数据存储系统提供了SQL能⼒,客户端协议是HTTP+JSON
-
调优
-
Fetch抓取(Hive可以避免进行MapReduce)
Hive中对某些情况的查询可以不必使用MapReduce计算。例如:SELECT * FROM employees;在这种情况下,Hive可以简单地读取employee对应的存储目录下的文件,然后输出查询结果到控制台。
在hive-default.xml.template文件中hive.fetch.task.conversion默认是more,老版本hive默认是minimal,该属性修改为more以后,在全局查找、字段查找、limit查找等都不走mapreduce。
-
本地模式
大多数的Hadoop Job是需要Hadoop提供的完整的可扩展性来处理大数据集的。不过,有时Hive的输入数据量是非常小的。在这种情况下,为查询触发执行任务时消耗可能会比实际job的执行时间要多的多。对于大多数这种情况,Hive可以通过本地模式在单台机器上处理所有的任务。对于小数据集,执行时间可以明显被缩短。
用户可以通过设置hive.exec.mode.local.auto的值为true,来让Hive在适当的时候自动启动这个优化。
-
分区表分桶表
分区表对sql过滤查询是一种优化 分桶表对join操作时提升性能很大,桶为表加上了额外的结构,Hive 在处理有些查询时能利用这个结构。具体而言,连接两个在(包含连接列的)相同列上划分了桶的表,可以使用 Map 端连接 (Map-side join)高效的实现。比如JOIN操作。对于JOIN操作两个表有一个相同的列,如果对这两个表都进行了桶操作。那么将保存相同列值的桶进行JOIN操作就可以,可以大大较少JOIN的数据量。 ———————————————— 版权声明:本文为CSDN博主「拉格朗日(Lagrange)」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。 原文链接:https://blog.csdn.net/qq_43061290/article/details/125105485
-
小表Join大表
-
mapjoin
MAPJION会把小表全部读入内存中,在map阶段直接拿另外一个表的数据和内存中表数据做匹配,由于在map是进行了join操作,省去了reduce运行的效率也会高很多
-
group by
-
Map数
input的文件总个数,input的文件大小,集群设置的文件块大小(目前为128M,可在hive中通过set dfs.block.size;
假设input目录下有3个文件a,b,c大小分别为10m,20m,150m,那么hadoop会分隔成4个块(10m,20m,128m,22m),从而产生4个map数。即,如果文件大于块大小(128m),那么会拆分,如果小于块大小,则把该文件当成一个块。 如果一个任务有很多小文件(远远小于块大小128m),则每个小文件也会被当做一个块,用一个map任务来完成,而一个map任务启动和初始化的时间远远大于逻辑处理的时间,就会造成很大的资源浪费。而且,同时可执行的map数是受限的。
比如有一个127m的文件,正常会用一个map去完成,但这个文件只有一个或者两个小字段,却有几千万的记录,如果map处理的逻辑比较复杂,用一个map任务去做,肯定也比较耗时。
减少map数 hive.merge.mapfiles,True时会合并map输出。 2、hive.merge.mapredfiles,True时会合并reduce输出。 3、hive.merge.size.per.task,合并操作后的单个文件大小。 4、hive.merge.size.smallfiles.avgsize,当输出文件平均大小小于设定值时,启动合并操作。这一设定只有当hive.merge.mapfiles或hive.merge.mapredfiles设定为true时,才会对相应的操作有效。
减少Map个数,需要增大mapred.min.split.size的值,减少set mapred.map.tasks的个数; 增大Map个数,需要减少mapred.min.split.size的值,增大set mapred.map.tasks的个数;
-
reduce数
调整reduce个数方法一 (1)每个Reduce处理的数据量默认是256MB
hive.exec.reducers.bytes.per.reducer=256123456
(2)每个任务最大的reduce数,默认为1009
hive.exec.reducers.max=1009
调整reduce个数方法二
在hadoop的mapred-default.xml文件中修改
设置每个job的Reduce个数
set mapreduce.job.reduces = 15;
reduce个数并不是越多越好
1)过多的启动和初始化reduce也会消耗时间和资源;
2)另外,有多少个reduce,就会有多少个输出文件,如果生成了很多个小文件,那么如果这些小文件作为下一个任务的输入,则也会出现小文件过多的问题;
在设置reduce个数的时候也需要考虑这两个原则:处理大数据量利用合适的reduce数;使单个reduce任务处理数据量大小要合适; ———————————————— 版权声明:本文为CSDN博主「拉格朗日(Lagrange)」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。 原文链接:https://blog.csdn.net/qq_43061290/article/details/125105485
-
jvm重用
VM重用是Hadoop调优参数的内容,其对Hive的性能具有非常大的影响,特别是对于很难避免小文件的场景或task特别多的场景,这类场景大多数执行时间都很短。
JVM重用可以使得JVM实例在同一个job中重新使用N次。N的值可以在Hadoop的mapred-site.xml文件中进行配置。通常在10-20之间, 缺点:
开启JVM重用将一直占用使用到的task插槽,以便进行重用,直到任务完成后才能释放。如果某个“不平衡的”job中有某几个reduce task执行的时间要比其他Reduce task消耗的时间多的多的话,那么保留的插槽就会一直空闲着却无法被其他的job使用,直到所有的task都结束了才会释放。 ———————————————— 版权声明:本文为CSDN博主「拉格朗日(Lagrange)」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。 原文链接:https://blog.csdn.net/qq_43061290/article/details/125105485
-
数据压缩与存储格式
压缩可以节约磁盘的空间,基于文本的压缩率可达40%+; 压缩可以增加吞吐量和性能量(减小载入内存的数据量),但是在压缩和解压过程中会增加CPU的开销。所以针对IO密集型的jobs(非计算密集型)可以使用压缩的方式提高性能。 几种压缩算法:
-
并行执行
当一个sql中有多个job时候,且这多个job之间没有依赖,则可以让顺序执行变为并行执行(一般为用到union all ) // 开启任务并行执行 set hive.exec.parallel=true; // 同一个sql允许并行任务的最大线程数 set hive.exec.parallel.thread.number=8;
-
合并小文件
小文件的产生有三个地方,map输入,map输出,reduce输出,小文件过多也会影响hive的分析效率:
设置map输入的小文件合并 set mapred.max.split.size=256000000;
//一个节点上split的至少的大小(这个值决定了多个DataNode上的文件是否需要合并) set mapred.min.split.size.per.node=100000000; //一个交换机下split的至少的大小(这个值决定了多个交换机上的文件是否需要合并)
set mapred.min.split.size.per.rack=100000000; //执行Map前进行小文件合并设置map输出和reduce输出进行合并的相关参数: //设置map端输出进行合并,默认为true set hive.merge.mapfiles = true //设置reduce端输出进行合并,默认为false set hive.merge.mapredfiles = true //设置合并文件的大小 set hive.merge.size.per.task = 25610001000 //当输出文件的平均大小小于该值时,启动一个独立的MapReduce任务进行文件merge。 set hive.merge.smallfiles.avgsize=16000000
-
hive的数据倾斜
表现:任务进度长时间维持在99%(或100%),查看任务监控页面,发现只有少量(1个或几个)reduce子任务未完成。因为其处理的数据量和其他reduce差异过大。
原因:某个reduce的数据输入量远远大于其他reduce数据的输入量
-
-
-
hbase
HBase 是一种分布式、可扩展、支持海量数据存储的 NoSQL 数据库。但从 HBase 的底层物理存储结构(K-V)来看,HBase 更像是一个 multi-dimensional map 官方建议 列族不超过三个 RowKey 的设计十分重要
map/reduce
分而治之,先分后和:将一个大的、复杂的工作或任务,拆分成多个小的任务,并行处理,最终进行合并。 MapReduce由Map和Reduce组成 Map: 将数据进行拆分,即把复杂的任务分解为若干个“简单的任务”来并行处理。可以进行拆分的前提是这些小任务可以并行计算,彼此间几乎没有依赖关系。 Reduce:对数据进行汇总,即对map阶段的结果进行全局汇总。
数据处理框架
spark
flink
数据中间件
elasticsearch
一个分布式的实时文档存储,每个字段 可以被索引与搜索 一个分布式实时分析搜索引擎 能胜任上百个服务节点的扩展,并支持 PB 级别的结构化或者非结构化数据
-
倒排索引
图书 正排索引-目录页 倒排索引-英文首字母索引页
搜索引擎 正排索引-文档id到文档内容和单词的关联 倒排索引-单词到文档id的关系
kafka
Kafka是一个分布式、支持分区的(partition)、多副本的(replica),基于zookeeper协调的分布式消息系统
clickhouse
俄罗斯yandex开发 C++编写
列式存储 覆盖标准sql大部分语法 DDL和DML 多样化的存储引擎 高吞吐写入能力 ClickHouse 采用类 LSM Tree 的结构,数据写入后定期在后台 Compaction。通过类 LSM tree的结构, ClickHouse 在数据导入时全部是顺序 append 写,写入后数据段不可更改,在后台compaction 时也是多个段 merge sort 后顺序写回磁盘。顺序写的特性,充分利用了磁盘的吞吐能力
数据分区与线程级并行
ClickHouse 将数据划分为多个 partition,每个 partition 再进一步划分为多个 index granularity(索引粒度),然后通过多个 CPU核心分别处理其中的一部分来实现并行数据处理。在这种设计下, 单条 Query 就能利用整机所有 CPU。 极致的并行处理能力,极大的降低了查 询延时。所以, ClickHouse 即使对于大量数据的查询也能够化整为零平行处理。但是有一个弊端就是对于单条查询使用多 cpu,就不利于同时并发多条查询。所以对于高 qps 的查询业务,ClickHouse 并不是强项。
- 子主题 3
hudi
2015 Uber 创建 数据基于HDFS Ø 可插拔索引机制支持快速Upsert/Delete。 Ø 支持增量拉取表变更以进行处理。 Ø 支持事务提交及回滚,并发控制。 Ø 支持Spark、Presto、Trino、Hive、Flink等引擎的SQL读写。 Ø 自动管理小文件,数据聚簇,压缩,清理。 Ø 流式摄入,内置CDC源和工具。 Ø 内置可扩展存储访问的元数据跟踪。 Ø 向后兼容的方式实现表结构变更的支持。
Hudi可以提供这两种需求的实现。第一个是对record级别的更新,另一个是仅对增量数据的查询。且Hudi提供了对Hive、presto、Spark的支持,可以直接使用这些组件对Hudi管理的数据进行查询。
nginx
俄罗斯yandex(烟大可死) Nginx (engine x) 是一个高性能的HTTP和反向代理web服务器,同时也提供了IMAP/POP3/SMTP服务 它的稳定性、丰富的功能集、简单的配置文件和低系统资源的消耗
-
反向代理
正向代理需要主动设置代理服务器ip或者域名进行访问,由设置的服务器ip或者域名去访问内容并返回 正向代理是代理客户端,为客户端收发请求,使真实客户端对服务器不可见。 正向代理需要配置代理服务器,而反向代理不需要做任何设置。 反向代理是代理服务器,为服务器收发请求,使真实服务器对客户端不可见。
SQL调优
数据湖
数据调度:T+1,慢,实时化 数据同步:T+1,merge,数据量大,周期长 修复回刷:修复好后数据回刷,数据量大
传统的离线数仓,通常数据是T+1的,不能满足对当日数据分析的需求,而流式计算一般是基于窗口,并且窗口逻辑相对比较固定。 现有一类特殊的需求,业务分析比较熟悉现有事务数据库的数据结构,并且希望有很多即席分析,这些分析包含当日比较实时的数据。惯常他们是基于Mysql从库,直接通过Sql做相应的分析计算。但很多时候会遇到如下障碍
数据量较大、分析逻辑较为复杂时,Mysql从库耗时较长 一些跨库的分析无法实现 诸如Apache Hudi和Apache Kudu则相当于现有OLTP和OLAP技术的桥梁。他们能够以现有OLTP中的数据结构存储数据,支持CRUD,同时提供跟现有OLAP框架的整合(如Hive,Impala),以实现OLAP分析
数据库
高性能数据库优化实战经验
1.打破范式设计,冗余少量字段方便查询,需要注意源表和冗余表保证同一事务写。 2.关联关系在业务层面约束,不依赖数据库外键 3.字段拓展性,如模板信息这种结构不清晰的字段使用json类型,json检索的问题我的想法是少量key使用虚拟列并建立索引,多条件检索直接异构es 4.冷热分离,源表拆分成多张表,可以把频繁变更的字段放在主表,使用率较低的放在副表,判断依据可以是创建时间、业务域 5.服务拆分在分片字段选择上尽量考虑使用本地事务,让同业务的不同sql命中同一个分表,以避免使用分布式事务 6.尽量使用单表维度sql,原因:join性能差,后期分库分表更方便,前瞻性设计要考虑使用哪种ID主键策略
生产问题
调用方只调用一次,服务方会执行两次
通过elk查看链路日志,发现提供方确实被执行两次,调用间隔非常短,使用aop去拦截整个调用边界的日志(最后发现这个日志不一定是真实的调用日志,aop是没有切到)最后发现是feign重试机制造成的
解决方案 1.分布式锁+数据库的唯一键 2.直接关闭重试机制 (会影响高可用) 3.注解加 切面或者拦截器 横向需求 抽象出来,需要实现幂等的接口,只需要加上注解