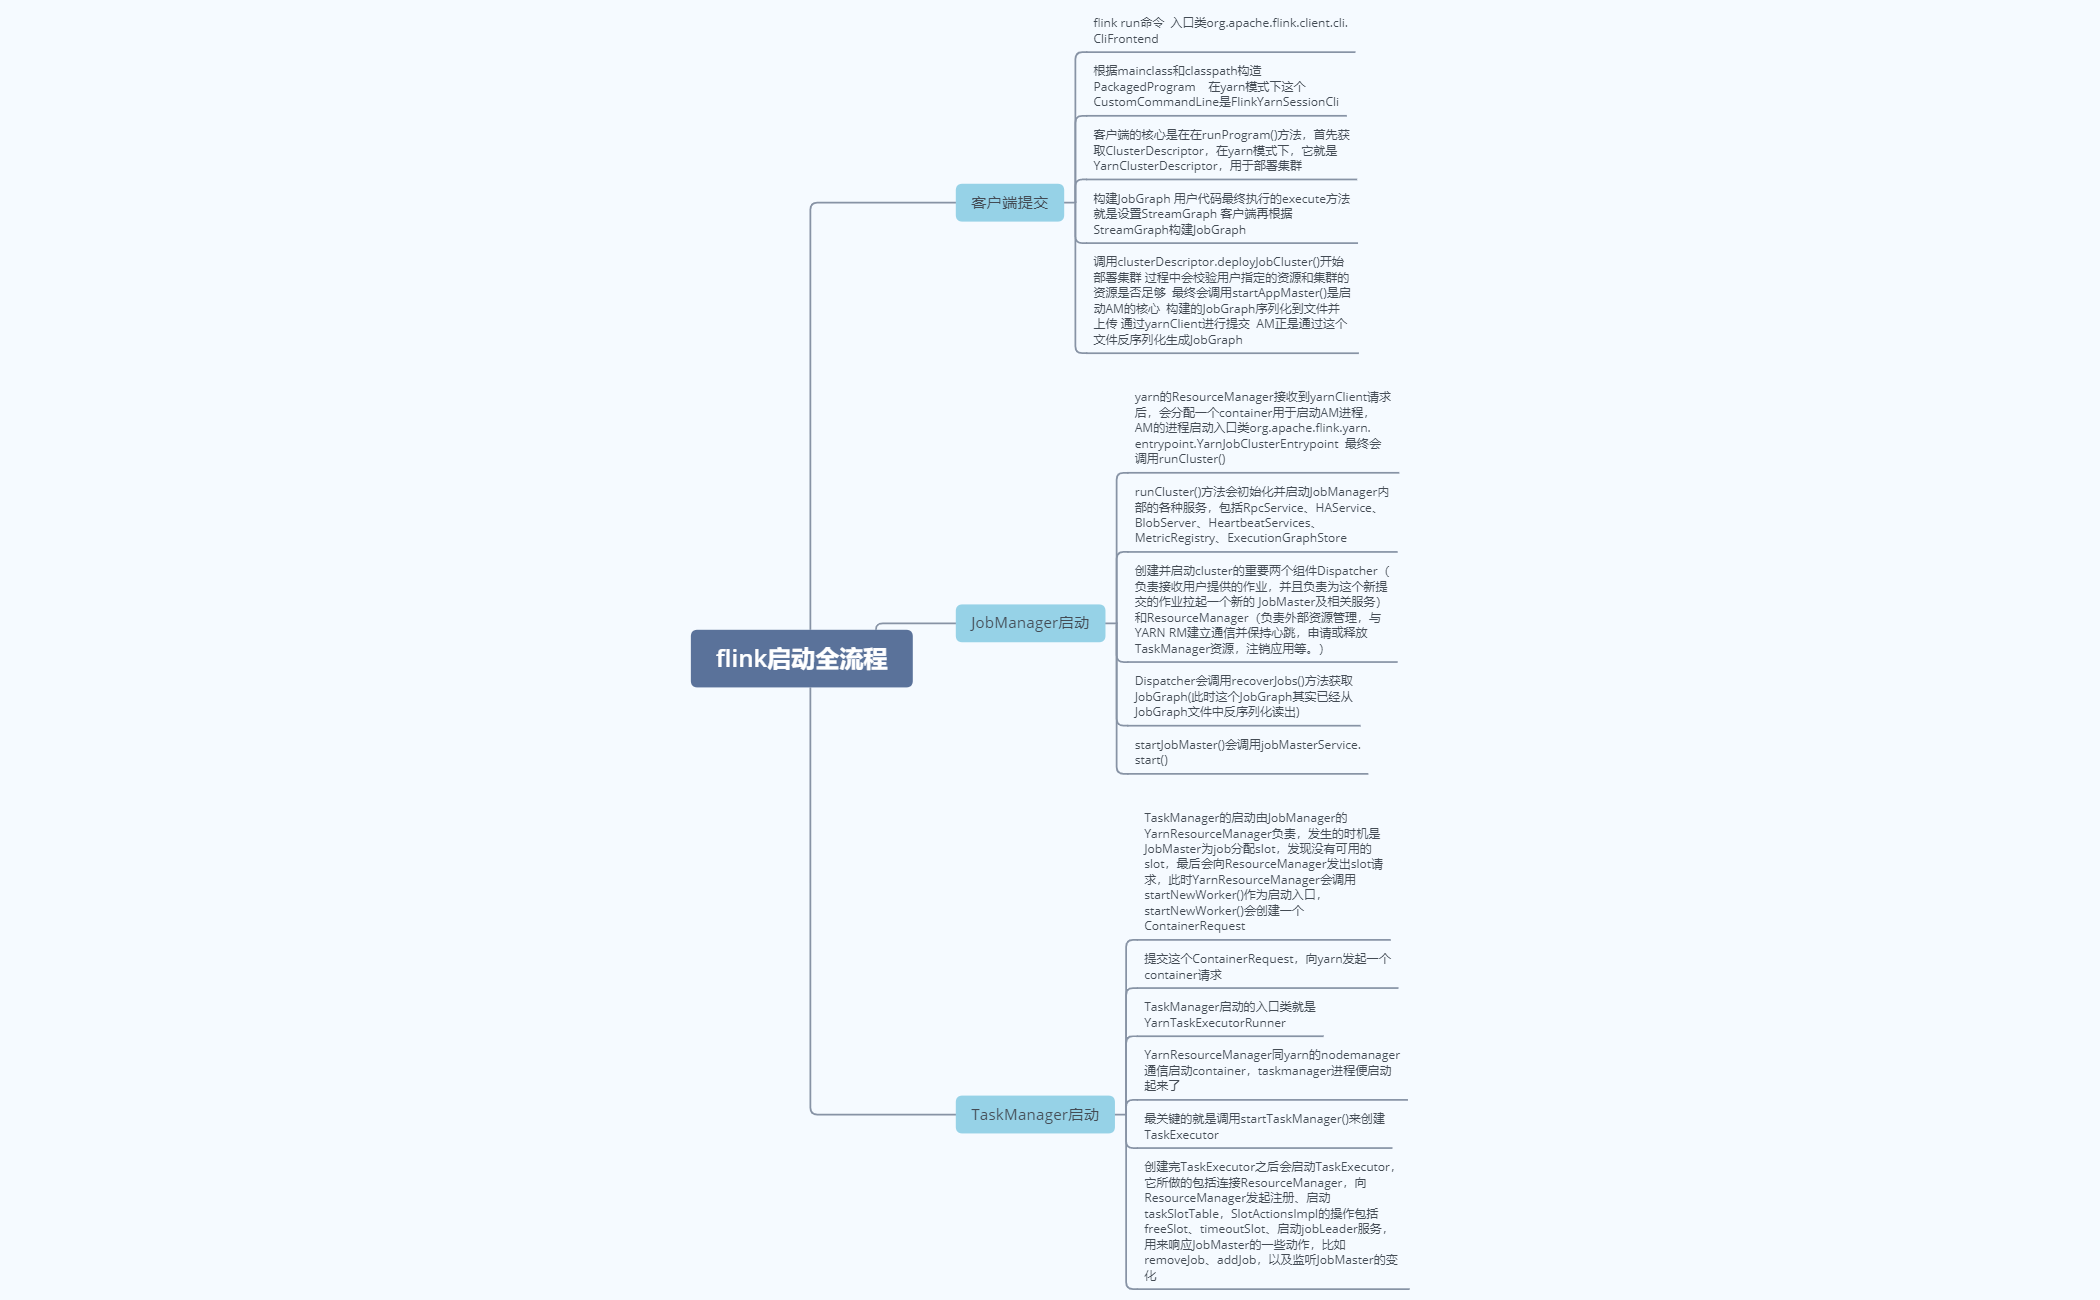
客户端提交 flink run命令 入口类org.apache.flink.client.cli.CliFrontend 根据mainclass和classpath构造PackagedProgram 在yarn模式下这个CustomCommandLine是FlinkYarnSessionCli 客户端的核心是在在runProgram()方法,首先获取ClusterDescriptor,在yarn模式下,它就是YarnClusterDescriptor,用于部署集群 构建JobGraph 用户代码最终执行的execute方法就是设置StreamGraph 客户端再根据StreamGraph构建JobGraph 调用clusterDescriptor.deployJobCluster()开始部署集群 过程中会校验用户指定的资源和集群的资源是否足够 最终会调用startAppMaster()是启动AM的核心 构建的JobGraph序列化到文件并上传 通过yarnClient进行提交 AM正是通过这个文件反序列化生成JobGraph JobManager启动 yarn的ResourceManager接收到yarnClient请求后,会分配一个container用于启动AM进程,AM的进程启动入口类org.apache.flink.yarn.entrypoint.YarnJobClusterEntrypoint 最终会调用runCluster() runCluster()方法会初始化并启动JobManager内部的各种服务,包括RpcService、HAService、BlobServer、HeartbeatServices、MetricRegistry、ExecutionGraphStore 创建并启动cluster的重要两个组件Dispatcher(负责接收用户提供的作业,并且负责为这个新提交的作业拉起一个新的 JobMaster及相关服务)和ResourceManager(负责外部资源管理,与YARN RM建立通信并保持心跳,申请或释放TaskManager资源,注销应用等。) Dispatcher会调用recoverJobs()方法获取JobGraph(此时这个JobGraph其实已经从JobGraph文件中反序列化读出) startJobMaster()会调用jobMasterService.start() TaskManager启动 TaskManager的启动由JobManager的YarnResourceManager负责,发生的时机是JobMaster为job分配slot,发现没有可用的slot,最后会向ResourceManager发出slot请求,此时YarnResourceManager会调用startNewWorker()作为启动入口,startNewWorker()会创建一个ContainerRequest 提交这个ContainerRequest,向yarn发起一个container请求 TaskManager启动的入口类就是YarnTaskExecutorRunner YarnResourceManager同yarn的nodemanager通信启动container,taskmanager进程便启动起来了 最关键的就是调用startTaskManager()来创建TaskExecutor 创建完TaskExecutor之后会启动TaskExecutor,它所做的包括连接ResourceManager,向ResourceManager发起注册、启动taskSlotTable,SlotActionsImpl的操作包括freeSlot、timeoutSlot、启动jobLeader服务,用来响应JobMaster的一些动作,比如removeJob、addJob,以及监听JobMaster的变化