不能先去数据库查询再判断再去扣减,多线程去查然后扣减肯定有超卖的情况 方案一: update stock set stock_count=stock_count-1 where item_id=1 and stock_count>=1 实际上就是有一把行锁,底层串行执行 rt(响应时长)就会飙高 tps就会上不去 QPS vs TPS:QPS基本类似于TPS,但是不同的是,对于一个页面的一次访问,形成一个TPS;但一次页面请求,可能产生多次对服务器的请求,服务器对这些请求,就可计入“QPS”之中。如,访问一个页面会请求服务器2次,一次访问,产生一个“T”,产生2个“Q”。 方案二: 库存表放入redis 扣减在redis中做 现实是在更新库存的同时,还要维护一张库存的流水表,这两个操作本质是在一个事务当中进行的 无法保证原子性 思考: 针对这种并发资源的争抢,提升并发度,主要就是降低锁的粒度和锁的持有时间 降低锁的粒度 可以采用分库分表 但是会涉及数据的迁移 改造成本比较大 只有少量的爆品会有这样的问题 为了这么少的爆品 去做整个数据库模型层面的改动 锁的持有时间 每个用户同时去抢一个商品,难道都需要去持有这个行锁吗?可不可以有一个队列,批量去数据库进行扣减 内存中设计一个队列,这个队列在非常少的时间段 比如200ms 放入用户请求,起一个异步线程把这200毫秒里面的所有这个商品的库存扣减 一下就把tps 从200拉到2000 用户确实是在同步等待,一个用户运气最差,可能会等200ms 基于当时用户场景,这一点完全可以容忍的 是否生成这个队列,也是根据当前的一个并发数,在内存里有一个计数器,记录每一个商品的并发请求数 超过3个才会创建这个队列 这里有个问题,这个方案的确降低了io的次数,但是如果异步合并的线程报错了,对上游来讲的话,就是超时扣减失败。而对于当前来说,这个报错可能在提交事务之前也可能是提交事务之后 如果提交之后,对于本地,是扣减成功的,对于上游是扣减失败,导致数据不一致 这就是一个分布式事务的问题 这时候上游发出消息,当前订单编号失败,本地监听这个消息,根据库存流水号来回滚事务 来保证最终的一致性
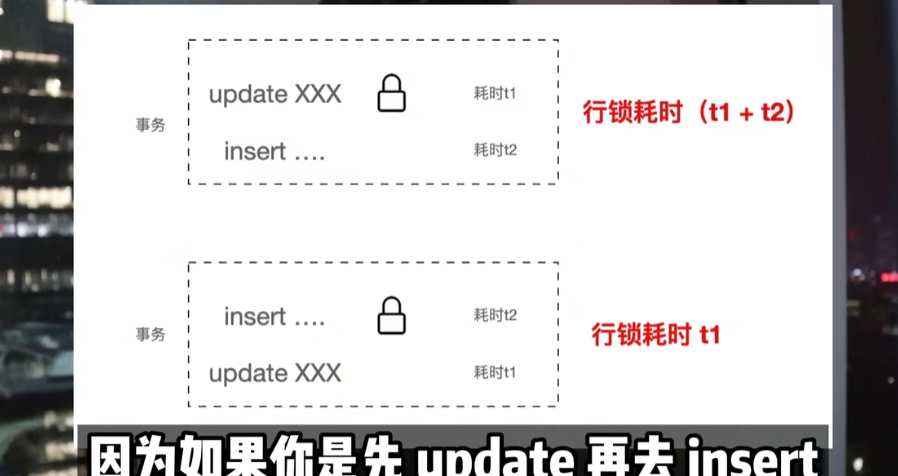
流水表的DDL操作,先insert再update同一个商品id insert操作 数据量大之后,需要做冷热分离,还有构建索引所以耗时会越来越多
商品的列表、详情页【库存数量】放在redis方便查询,由于ms级别且读写频繁,如何做到数据一致性
刚开始采用 cache aside 先更新数据库在删除redis 这个时间想省掉
缓存命中率低, 因为库存频繁更新,上游没查多少次,就更新成另外的值;因为页面上的库存值没有那么敏感,只要保证不超卖
针对 缓存命中率低 监听DB 的binlog异步同步到redis,由另外一个模块去做, 设计时间窗口,如果5秒库存有更新,所以会5秒钟刷新一次redis,由于binlog可能并行的来,所以会消息乱序,添加version来防止更新时候最新版本
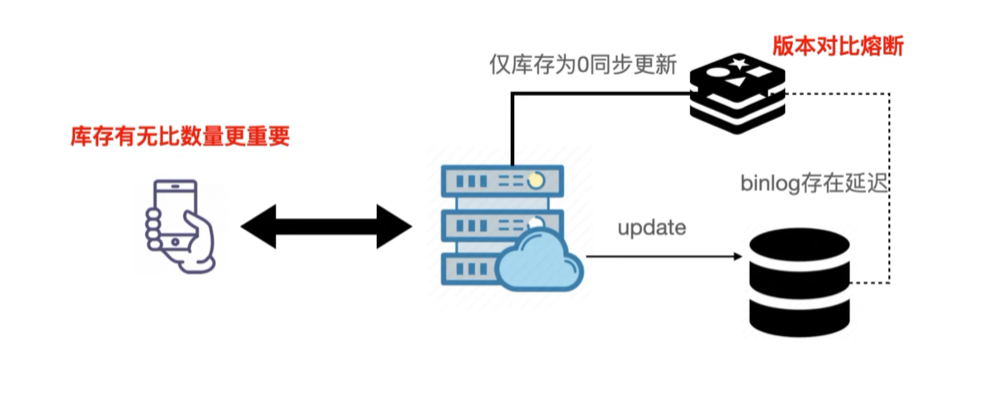
【使用监听DB 的binlog同步到redis上,注意:这种刷新带有时间间隔,在监听中设定定时5秒钟去刷新,并添加version来防止更新时候最新版本】
采用iv方案之后真实库存与缓存存在数据不一致,当实际为0的真实库存通知redis同步为0时,binlog会覆盖真实值情况【版本号来判断防止覆盖】 其他细节判断 这个扣减在横向扩容时,各个机器合并数据效果会变差,弹性扩容不是太好【改进方案:扣减拿出来做一个专门集群,避免和其他接口沾合】 调优:等待队列时间间隔、线程池设置大小、并发的数量、多久创建队列等参数需要调优 淘宝应对方案 专门一个接口处理这块,但是DB【mysql集群】制作中间件添加队列去存储请求 所有队列均不在逻辑代码层级上处理,所以没有水平扩容 成果:相关接口的tps由200多到10000多的扩大5倍